Resultados medidos: cómo resisten las correcciones
Cada corrección que hace CECO PDF se comprueba píxel a píxel, y esa comprobación no dice nada sobre lo fácil que es encontrar la corrección después. Esta página sí lo dice. Publica lo que encontraron nuestros propios detectores forenses y un revisor cuando fueron a buscarla, en páginas inventadas creadas para ello, con las filas flojas incluidas. Cada número de esta página se genera a partir de los resultados guardados del banco de pruebas; ninguno se escribe a mano.
Los números del banco de pruebas se guardaron el 25 de octubre de 2026; los de la revisión a ciegas, el 21 de septiembre de 2026. Versión del motor 0.1.1.
Qué se mide
El banco de pruebas crea 200 páginas inventadas: cartas, extractos y formularios escritos para ello, sin nombres, direcciones ni cifras reales. Después, cada una se escanea por software como se escanearía una página real, en cuatro condiciones:
- Cámara de teléfono. Una página fotografiada con un teléfono: luz desigual, un poco de inclinación, el ruido del sensor y el JPEG que guarda la cámara.
- Escáner de oficina. Un escaneo de escáner plano guardado como JPEG, el tipo de escaneo más común que existe.
- Fax. Una página solo en blanco y negro, sin ningún gris, tal como la entrega un fax o un escáner bitonal.
- Membrete en color. Un escaneo en color de una página con una cabecera y una franja lateral de color.
En cada página se pide al motor una corrección, de cuatro tipos:
- Una palabra reemplazada: una palabra de la página pasa a ser otra.
- Un dígito cambiado: un dígito de una cantidad pasa a ser el siguiente.
- Una palabra quitada: se quita una palabra y se cierra el hueco de la línea.
- Una palabra añadida: se coloca una palabra sobre papel en blanco medido junto al texto.
Una corrección que el motor no puede hacer bien se rechaza, y un rechazo se cuenta, no se puntúa. Cada corrección que sí hace se comprueba igual que el servicio comprueba las tuyas: la página se renderiza antes y después a 300 puntos por pulgada y se compara, y la corrección solo cuenta si cada píxel cambiado está dentro de la zona que declaró.
Después, la página corregida, y solo la página corregida, se entrega a diez detectores forenses que escribimos contra nosotros mismos. Cada uno es una medición clásica del tipo que hace el software de un perito documental, y cada uno devuelve un mapa de dónde cree que se hizo algo en la página:
- Residuo de recompresión: cuánto cambia cada parte de la página cuando se vuelve a guardar como JPEG con varias calidades.
- Fantasmas JPEG: la huella que deja una segunda compresión en la curva del residuo.
- Historial de cuantificación: si los coeficientes de compresión llevan el propio historial de la página u otro.
- Rejilla de compresión: si los límites de bloque del JPEG coinciden en todas partes.
- Ruido del papel: si el grano del papel en blanco es igual en todas partes.
- Huellas de remuestreo: el residuo periódico que deja escalar o rotar píxeles.
- Nitidez de bordes: lo rápido que la tinta pasa a papel a lo largo de los bordes marcados.
- Bloques copiados: bloques de píxeles que aparecen dos veces en la página.
- Iluminación: si el brillo del papel sigue un único campo de luz uniforme.
- Formas en blanco y negro: los tamaños, las formas y las longitudes de los trazos de tinta en una página sin gris.
Cada mapa se puntúa frente a la verdad, que ningún detector ve: los píxeles exactos que cambió la corrección. La puntuación es el área bajo la curva, y la LOCALIZABILIDAD de una página es la puntuación más alta que alcanzó cualquier detector en ella. 0,5 significa que el detector no lo hizo mejor que lanzar una moneda; 1,0 significa que trazó una línea alrededor de la corrección. La cifra de una fila es la media de las correcciones que aceptó. Cuanto más bajo, mejor para nosotros, y al atacante se le da toda la ventaja: puede elegir su detector más fuerte después de ver cada página.
Los números
Hoy, el detector más fuerte localiza con facilidad una corrección aceptada. En todas las condiciones, la cifra es 0,914, con 94 correcciones hechas y 106 rechazadas, de 200 pedidas. Incluso la condición en la que las correcciones son más difíciles de encontrar, membrete en color con 0,871, está muy lejos de lanzar una moneda. La ejecución completa tarda unos 24 minutos en dos núcleos de procesador.
LOCALIZABILIDAD por condición de escaneo: cuanto más bajo, mejor; 0,5 es lanzar una moneda
| Condición | LOCALIZABILIDAD | Correcciones hechas | Rechazadas |
|---|---|---|---|
| Cámara de teléfono | 0,981 | 10 | 42 |
| Escáner de oficina | 0,883 | 26 | 26 |
| Fax | 0,989 | 22 | 26 |
| Membrete en color | 0,871 | 36 | 12 |
| Todas las condiciones | 0,914 | 94 | 106 |
En todas las filas, el recuento de píxeles cambiados fuera de la zona declarada es 0: la comprobación se cumplió en cada corrección hecha.
Cada condición y cada tipo de corrección
Todas las filas del banco de pruebas
| Condición | Corrección | LOCALIZABILIDAD | Hechas | Rechazadas | Cambiado fuera de la zona | Similitud en el recuadro cambiado | Nitidez del parche frente a su anillo | Cómo se hicieron las correcciones |
|---|---|---|---|---|---|---|---|---|
| Cámara de teléfono | una palabra reemplazada | 0,988 | 2 | 11 | 0 | 0,629 | 1,748 | ajustado a las letras de alrededor: 2 |
| Cámara de teléfono | un dígito cambiado | 0,964 | 2 | 11 | 0 | 0,266 | 2,138 | ajustado a las letras de alrededor: 2 |
| Cámara de teléfono | una palabra quitada | 0,965 | 2 | 11 | 0 | 0,302 | 1,816 | hecho con las propias marcas de la página: 2 |
| Cámara de teléfono | una palabra añadida | 0,995 | 4 | 9 | 0 | 0,025 | 2,178 | ajustado a las letras de alrededor: 4 |
| Escáner de oficina | una palabra reemplazada | 0,923 | 5 | 8 | 0 | 0,274 | 1,922 | ajustado a las letras de alrededor: 5 |
| Escáner de oficina | un dígito cambiado | 0,927 | 10 | 3 | 0 | 0,456 | 3,136 | ajustado a las letras de alrededor: 10 |
| Escáner de oficina | una palabra quitada | 0,824 | 11 | 2 | 0 | 0,239 | 1,775 | hecho con las propias marcas de la página: 9, ajustado a las letras de alrededor: 2 |
| Escáner de oficina | una palabra añadida | n/d | 0 | 13 | 0 | n/d | n/d | ninguna |
| Fax | una palabra reemplazada | 0,985 | 2 | 10 | 0 | 0,786 | 2,030 | ajustado a las letras de alrededor: 2 |
| Fax | un dígito cambiado | 0,999 | 1 | 11 | 0 | 0,245 | 1,979 | ajustado a las letras de alrededor: 1 |
| Fax | una palabra quitada | 0,982 | 11 | 1 | 0 | 0,271 | 2,515 | hecho con las propias marcas de la página: 11 |
| Fax | una palabra añadida | 0,998 | 8 | 4 | 0 | 0,012 | 4,355 | ajustado a las letras de alrededor: 8 |
| Membrete en color | una palabra reemplazada | 0,848 | 9 | 3 | 0 | 0,392 | 1,739 | ajustado a las letras de alrededor: 9 |
| Membrete en color | un dígito cambiado | 0,904 | 8 | 4 | 0 | 0,575 | 2,134 | ajustado a las letras de alrededor: 8 |
| Membrete en color | una palabra quitada | 0,808 | 9 | 3 | 0 | 0,199 | 1,617 | hecho con las propias marcas de la página: 8, ajustado a las letras de alrededor: 1 |
| Membrete en color | una palabra añadida | 0,924 | 10 | 2 | 0 | 0,009 | 2,269 | ajustado a las letras de alrededor: 10 |
«Cambiado fuera de la zona» cuenta los píxeles que las correcciones de una fila cambiaron fuera de lo que declaró cada una, sumados en la fila. «Similitud en el recuadro cambiado» es el SSIM entre el antes y el después dentro del recuadro más pequeño que contiene todos los píxeles cambiados, donde un recuadro que cambió por completo da un valor bajo. «Nitidez del parche frente a su anillo» divide la relación entre nitidez y ruido del parche corregido por la del papel y el texto que lo rodean, así que un parche que se lee igual que su entorno queda cerca de uno. «Cómo se hicieron las correcciones» cuenta las correcciones de las filas por resultado, con las palabras que usa la aplicación.
Dónde sale mal
Una página solo con buenas cifras parecería publicidad. Estas son las condiciones en las que una corrección se encuentra con más facilidad que la cifra global del banco de pruebas, por qué, y qué se está haciendo con cada una.
Cámara de teléfono: 0,981
Una fotografía de teléfono lleva el ruido del sensor, el suavizado de la lente y una luz desigual en la página. Las letras dibujadas igualan el desenfoque y el grano medidos a su alrededor, pero no lo bastante: las mediciones de cuantificación y de iluminación siguen separando el parche de la página. Casi la mitad de las correcciones pedidas en páginas de teléfono se rechazaron, la mayoría porque la inclinación de la página hacía que el plan no fuera seguro.
Próximo paso: un modelo del ruido del sensor, e igualar el historial de compresión de la fotografía, para que un parche dibujado lleve el mismo grano y el mismo JPEG que la página que lo rodea.
Fax: 0,989
Una página de fax solo tiene blanco y negro. Las letras que dibuja el motor llevan suavizado de bordes, con gris a lo largo de sus contornos, así que quedan sobre una página que no tiene gris en ningún otro sitio, y una medición de las formas de los bordes o del campo de ruido las encuentra enseguida. Saberlo no es lo mismo que arreglarlo.
Próximo paso: dibujar en una página en blanco y negro en blanco y negro, ajustado a los propios grosores de trazo y escalones de borde de la página, en lugar de en gris.
Rechazado siempre
Escáner de oficina, una palabra añadida: pedida 13 veces, hecha 0. No hay número para esta fila porque no se hizo ninguna corrección. Cada intento lo rechazaron las propias comprobaciones del motor: en este tipo de escaneo, la palabra dibujada mide más suave o más nítida que la textura JPEG que la rodea, o no cabe en el espacio en blanco medido para ella. El motor prefiere no hacerlo antes que poner una palabra que llamaría la atención.
Y a ojos de una persona
Los detectores son una cosa. A un revisor se le mostraron 20 pares de páginas, una original y otra corregida, en orden ciego, y se le pidió que dijera cuál era la corregida. Acertó 17 veces de 20; una moneda acertaría la mitad de las veces.
La revisión a ciegas, por condición de escaneo
| Condición | Encontradas | Mostradas |
|---|---|---|
| Cámara de teléfono | 5 | 5 |
| Escáner de oficina | 3 | 5 |
| Fax | 5 | 5 |
| Membrete en color | 4 | 5 |
| Todas las condiciones | 17 | 20 |
El revisor había construido el sistema de pruebas y sabía qué palabras cambia el banco de pruebas, así que este es un resultado para encontrar fallos, no una medida de lo que vería un desconocido. Se publica porque es lo que se midió.
Una corrección, paso a paso
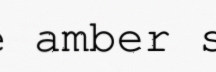
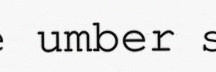
En lugar del ejemplo más favorable, esta página muestra uno elegido por una regla: una palabra reemplazada, que es la corrección para la que existe la herramienta, en la condición de escaneo cuya fila de reemplazo de palabras está más cerca de la cifra global del banco de pruebas; y, dentro de esa fila, la página que inspeccionan las propias pruebas del banco, que es la corrección aceptada que un detector encontró con más facilidad. Eso da escáner de oficina, una palabra reemplazada, semilla 73132: una carta inventada, escaneada en esa condición (un escaneo de escáner plano guardado como JPEG, el tipo de escaneo más común que existe), en la que la palabra «amber» de la primera línea del cuerpo pasa a ser «umber».
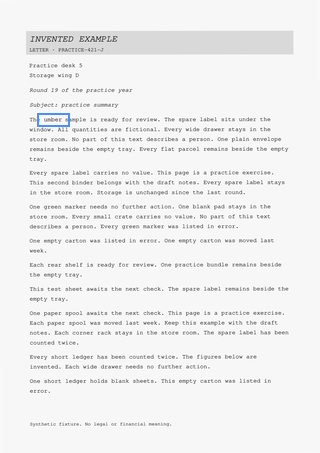
Cómo se hizo: Ajustado a las letras de alrededor. La página no contenía la tinta que necesita la palabra nueva, así que las letras se dibujaron para que coincidan con la letra de al lado, con su desenfoque, su grano y el color de su tinta tomados de lo que rodea la selección.
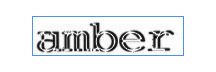
Los recortes de abajo son los propios píxeles de la página a 300 puntos por pulgada, mostrados a ocho veces su tamaño (cuatro en una pantalla pequeña), con cada píxel como un cuadrado y sin suavizado; desplázate hacia los lados para ver la línea entera. Cada píxel que cambió la corrección está dentro de la zona marcada en la tercera imagen.
La comprobación
Cambiaron 4780 píxeles, todos dentro de la zona declarada, que va de (336, 904) a (488, 944) en la cuadrícula de 300 puntos por pulgada; fuera de ella cambiaron 0. Comprobado.
Lo que encontraron los detectores
La puntuación de cada detector en esta página
| Detector | Qué mide | Puntuación |
|---|---|---|
| Residuo de recompresión | cuánto cambia cada parte de la página cuando se vuelve a guardar como JPEG con varias calidades | 0,944 |
| Fantasmas JPEG | la huella que deja una segunda compresión en la curva del residuo | 0,784 |
| Historial de cuantificación | si los coeficientes de compresión llevan el propio historial de la página u otro | 0,975 |
| Rejilla de compresión | si los límites de bloque del JPEG coinciden en todas partes | 0,836 |
| Ruido del papel | si el grano del papel en blanco es igual en todas partes | 0,734 |
| Huellas de remuestreo | el residuo periódico que deja escalar o rotar píxeles | 0,241 |
| Nitidez de bordes | lo rápido que la tinta pasa a papel a lo largo de los bordes marcados | 0,818 |
| Bloques copiados | bloques de píxeles que aparecen dos veces en la página | 0,498 |
| Iluminación | si el brillo del papel sigue un único campo de luz uniforme | 0,721 |
| Formas en blanco y negro | los tamaños, las formas y las longitudes de los trazos de tinta en una página sin gris | no aplicable |
El más fuerte fue el historial de cuantificación, con 0,975, y esa es la LOCALIZABILIDAD de esta página. Dicho claramente: nuestro propio detector trazó una línea alrededor de esta corrección. La similitud dentro del recuadro cambiado fue 0,287, y la nitidez del parche frente a su anillo, 1,935, así que las letras dibujadas se ven un poco más limpias que el escaneo que las rodea. Los recortes están arriba para que lo juzgues tú.
El registro y un certificado
El archivo corregido lleva su propio registro, un adjunto llamado
provenance.json. Para esta corrección dice: página
1, la zona de (336, 904) a (488, 944) a
300 puntos por pulgada, «amber» antes y
«umber» después, con el resultado «Ajustado a las letras de alrededor»,
comprobada, con 4780 píxeles
cambiados y 0 fuera de la zona
declarada, por la versión del motor 0.1.1. El registro identifica el archivo como
copia corregida. Es una declaración que el archivo hace sobre sí mismo; la prueba es el registro propio
del servicio, como explica Cómo funciona.
Un certificado de comprobación es una declaración firmada de las mismas mediciones, que se emite con el plan Business para un documento corregido y que cualquiera puede comprobar en la comprobación de certificados sin cuenta. Lo que demuestra una comprobación, campo por campo, está en el modelo de verificación.
No se ha emitido ningún certificado para esta corrección: los certificados se emiten para correcciones hechas en el servicio real, y esta se hizo en el banco de pruebas. Lo que contendría uno es la medición de arriba, firmada.
Las letras se dibujaron con las fuentes con las que funciona el servicio, y con ninguna otra, para que este ejemplo sea el que haría el servicio; CECO PDF mantiene esta página así generando el ejemplo de nuevo, con el propio conjunto de fuentes del servicio, cada vez que cambia el motor.
Cómo comprobar estos números
Todo lo que hay en esta página se genera a partir de los resultados guardados del banco de pruebas, y los mismos datos se sirven como JSON, para que un programa pueda leer los números y compararlos con la página. El banco de pruebas, los detectores y el generador del corpus forman parte del propio código del motor y de sus pruebas. El corpus es inventado y se genera a partir de una semilla: ningún documento real, ni ningún documento de un cliente, está en él ni lo estará nunca.
La página no se actualiza a mano. Cuando el banco de pruebas se vuelve a ejecutar y se publica su marcador, esta página se regenera a partir de él, y una prueba falla si los dos no coinciden.
Puedes reutilizar estos números, de esta página o del JSON, con la licencia Creative Commons Attribution 4.0 International: di que son de CECO PDF y enlaza a esta página. La licencia cubre las mediciones, no el motor, el servicio ni el resto de este sitio.
Lo que estos números no dicen
Se miden en páginas inventadas, no en documentos de clientes, que nunca salen del servicio y nunca se usan como datos de prueba. Cuatro condiciones de escaneo y cuatro tipos de corrección son un conjunto de regresión, no el mundo, y un número de esta página es una propiedad de ese conjunto el día en que se midió.
Son los números de nuestros propios detectores. Un perito documental con otras herramientas, más tiempo o una copia impresa de la página puede encontrar lo que estos no encuentran, y un número bajo aquí no sería una promesa de que una corrección no se puede encontrar. Hoy los números no son bajos.
Una corrección nunca se hace para ocultarse. Cada una lleva la declaración de la persona que la pidió y un registro dentro del archivo, y las condiciones dicen quién puede modificar un documento: solo alguien con derecho a modificarlo. Estas mediciones se publican para que se pueda comprobar la afirmación de que no cambió nada más en la página, y para que lo que hace la herramienta se sepa, no se suponga.
Última actualización