Messergebnisse: wie gut Korrekturen standhalten
Jede Korrektur, die CECO PDF vornimmt, wird Pixel für Pixel geprüft, und diese Prüfung sagt nichts darüber, wie leicht die Korrektur danach zu finden ist. Diese Seite schon. Die Seite veröffentlicht, was unsere eigenen forensischen Detektoren und eine prüfende Person gefunden haben, als sie danach suchten, auf erfundenen Seiten, die eigens dafür gebaut wurden, die schwachen Zeilen eingeschlossen. Jede Zahl hier wird aus den festgeschriebenen Ergebnissen des Benchmarks erzeugt; keine ist getippt.
Die Zahlen des Benchmarks wurden am 25. Oktober 2026 festgeschrieben, die der Blindprüfung am 21. September 2026. Programmversion 0.1.1.
Was gemessen wird
Der Benchmark baut 200 erfundene Seiten: Briefe, Aufstellungen und Formulare, eigens dafür geschrieben, ohne echte Namen, Adressen oder Zahlen darauf. Jede wird dann per Software so gescannt, wie eine echte Seite gescannt würde, unter vier Bedingungen:
- Handykamera. Eine mit dem Handy fotografierte Seite: ungleichmäßiges Licht, eine leichte Schräglage, das Rauschen des Sensors und das JPEG, das die Kamera speichert.
- Büroscanner. Ein Flachbettscan, als JPEG gespeichert, die häufigste Art von Scan überhaupt.
- Fax. Eine Seite nur in Schwarz und Weiß, nirgends Grau, so wie ein Fax oder ein Scanner für reine Schwarz-Weiß-Bilder sie liefert.
- Farbiger Briefkopf. Ein Farbscan einer Seite mit farbiger Kopfzeile und farbigem Seitenstreifen.
Auf jeder Seite wird das Programm um eine Korrektur gebeten, von vier Arten:
- Ein Wort ersetzt: Ein Wort auf der Seite wird zu einem anderen.
- Eine Ziffer geändert: Eine Ziffer einer Mengenangabe wird zur nächsten.
- Ein Wort entfernt: Ein Wort wird herausgenommen und die Zeile geschlossen.
- Ein Wort hinzugefügt: Ein Wort wird auf gemessenes leeres Papier neben die Schrift gesetzt.
Eine Korrektur, die das Programm nicht gut machen kann, wird abgelehnt, und eine Ablehnung wird gezählt, nicht bewertet. Jede Korrektur, die es vornimmt, wird so geprüft, wie der Dienst Ihre prüft: Die Seite wird vorher und nachher mit 300 Punkten pro Zoll gerendert und verglichen, und die Korrektur zählt nur, wenn jedes geänderte Pixel innerhalb des Bereichs liegt, den sie angegeben hat.
Dann wird die korrigierte Seite, und nur die korrigierte Seite, zehn forensischen Detektoren übergeben, die wir gegen uns selbst geschrieben haben. Jeder ist eine klassische Messung von der Art, wie sie die Software von Dokumentenprüfern vornimmt, und jeder liefert eine Karte, wo auf der Seite er glaubt, dass etwas verändert wurde:
- Rückstand der Neukompression: wie stark sich jeder Teil der Seite verändert, wenn er erneut als JPEG in mehreren Qualitätsstufen gespeichert wird.
- JPEG-Geisterbilder: die Spur, die eine zweite Kompression in der Rückstandskurve hinterlässt.
- Quantisierungsverlauf: ob die Kompressionskoeffizienten den eigenen Verlauf der Seite tragen oder einen anderen.
- Kompressionsraster: ob die Blockgrenzen des JPEG überall aufeinander ausgerichtet sind.
- Papierrauschen: ob die Körnung des leeren Papiers überall gleich ist.
- Spuren der Neuabtastung: der periodische Rückstand, den das Skalieren oder Drehen von Pixeln hinterlässt.
- Kantenschärfe: wie schnell Tinte entlang starker Kanten in Papier übergeht.
- Kopierte Blöcke: Pixelblöcke, die zweimal auf der Seite vorkommen.
- Beleuchtung: ob die Helligkeit des Papiers einem einzigen gleichmäßigen Lichtfeld folgt.
- Schwarz-Weiß-Formen: die Größen, Formen und Lauflängen der Tinte auf einer Seite ohne Grau.
Jede Karte wird an der Wahrheit gemessen, die kein Detektor sieht: an den genauen Pixeln, die die Korrektur geändert hat. Die Bewertung ist die Fläche unter der Kurve, und die AUFFINDBARKEIT einer Seite ist die höchste Bewertung, die ein Detektor auf ihr erreicht hat. 0,5 heißt, der Detektor war nicht besser als ein Münzwurf; 1,0 heißt, er hat die Korrektur genau umrandet. Die Zahl einer Zeile ist der Mittelwert über die Korrekturen, die sie angenommen hat. Niedriger ist für uns besser, und der Angreifer bekommt jeden Vorteil: Er darf sich nach dem Anblick jeder Seite seinen stärksten Detektor aussuchen.
Die Zahlen
Heute findet der stärkste Detektor eine angenommene Korrektur leicht. Über alle Bedingungen hinweg liegt die Zahl bei 0,914, aus 94 vorgenommenen und 106 abgelehnten Korrekturen, von 200 angefragten. Selbst die Bedingung, unter der Korrekturen am schwersten zu finden sind, farbiger Briefkopf mit 0,871, ist weit von einem Münzwurf entfernt. Der ganze Durchlauf dauert etwa 24 Minuten auf zwei Prozessorkernen.
AUFFINDBARKEIT nach Scanbedingung: niedriger ist besser, 0,5 ist ein Münzwurf
| Bedingung | AUFFINDBARKEIT | Vorgenommene Korrekturen | Abgelehnt |
|---|---|---|---|
| Handykamera | 0,981 | 10 | 42 |
| Büroscanner | 0,883 | 26 | 26 |
| Fax | 0,989 | 22 | 26 |
| Farbiger Briefkopf | 0,871 | 36 | 12 |
| Alle Bedingungen | 0,914 | 94 | 106 |
In jeder Zeile ist die Zahl der Pixel, die außerhalb des angegebenen Bereichs geändert wurden, 0: Die Prüfung hat bei jeder vorgenommenen Korrektur gehalten.
Jede Bedingung und jede Art von Korrektur
Jede Zeile des Benchmarks
| Bedingung | Korrektur | AUFFINDBARKEIT | Vorgenommen | Abgelehnt | Außerhalb des Bereichs geändert | Ähnlichkeit im geänderten Rahmen | Schärfe der Stelle gegenüber ihrem Ring | Wie die Korrekturen gemacht wurden |
|---|---|---|---|---|---|---|---|---|
| Handykamera | ein Wort ersetzt | 0,988 | 2 | 11 | 0 | 0,629 | 1,748 | an die umgebenden Buchstaben angepasst: 2 |
| Handykamera | eine Ziffer geändert | 0,964 | 2 | 11 | 0 | 0,266 | 2,138 | an die umgebenden Buchstaben angepasst: 2 |
| Handykamera | ein Wort entfernt | 0,965 | 2 | 11 | 0 | 0,302 | 1,816 | aus den eigenen Zeichen der Seite erstellt: 2 |
| Handykamera | ein Wort hinzugefügt | 0,995 | 4 | 9 | 0 | 0,025 | 2,178 | an die umgebenden Buchstaben angepasst: 4 |
| Büroscanner | ein Wort ersetzt | 0,923 | 5 | 8 | 0 | 0,274 | 1,922 | an die umgebenden Buchstaben angepasst: 5 |
| Büroscanner | eine Ziffer geändert | 0,927 | 10 | 3 | 0 | 0,456 | 3,136 | an die umgebenden Buchstaben angepasst: 10 |
| Büroscanner | ein Wort entfernt | 0,824 | 11 | 2 | 0 | 0,239 | 1,775 | aus den eigenen Zeichen der Seite erstellt: 9, an die umgebenden Buchstaben angepasst: 2 |
| Büroscanner | ein Wort hinzugefügt | entfällt | 0 | 13 | 0 | entfällt | entfällt | keine |
| Fax | ein Wort ersetzt | 0,985 | 2 | 10 | 0 | 0,786 | 2,030 | an die umgebenden Buchstaben angepasst: 2 |
| Fax | eine Ziffer geändert | 0,999 | 1 | 11 | 0 | 0,245 | 1,979 | an die umgebenden Buchstaben angepasst: 1 |
| Fax | ein Wort entfernt | 0,982 | 11 | 1 | 0 | 0,271 | 2,515 | aus den eigenen Zeichen der Seite erstellt: 11 |
| Fax | ein Wort hinzugefügt | 0,998 | 8 | 4 | 0 | 0,012 | 4,355 | an die umgebenden Buchstaben angepasst: 8 |
| Farbiger Briefkopf | ein Wort ersetzt | 0,848 | 9 | 3 | 0 | 0,392 | 1,739 | an die umgebenden Buchstaben angepasst: 9 |
| Farbiger Briefkopf | eine Ziffer geändert | 0,904 | 8 | 4 | 0 | 0,575 | 2,134 | an die umgebenden Buchstaben angepasst: 8 |
| Farbiger Briefkopf | ein Wort entfernt | 0,808 | 9 | 3 | 0 | 0,199 | 1,617 | aus den eigenen Zeichen der Seite erstellt: 8, an die umgebenden Buchstaben angepasst: 1 |
| Farbiger Briefkopf | ein Wort hinzugefügt | 0,924 | 10 | 2 | 0 | 0,009 | 2,269 | an die umgebenden Buchstaben angepasst: 10 |
„Außerhalb des Bereichs geändert“ zählt die Pixel, die die Korrekturen einer Zeile außerhalb dessen geändert haben, was jede angegeben hat, summiert über die Zeile. „Ähnlichkeit im geänderten Rahmen“ ist der SSIM zwischen vorher und nachher innerhalb des kleinsten Rahmens, der jedes geänderte Pixel enthält; ein Rahmen, der sich vollständig geändert hat, ergibt einen niedrigen Wert. „Schärfe der Stelle gegenüber ihrem Ring“ teilt das Verhältnis von Schärfe zu Rauschen der korrigierten Stelle durch das des Papiers und der Schrift um sie herum, sodass eine Stelle, die sich wie ihre Umgebung liest, nahe bei eins liegt. „Wie die Korrekturen gemacht wurden“ zählt die Korrekturen der Zeilen nach Ergebnis, mit den Worten, die die App verwendet.
Wo es schlecht abschneidet
Eine Seite mit nur guten Zahlen würde sich wie Werbung lesen. Das sind die Bedingungen, unter denen eine Korrektur leichter gefunden wird als bei der Gesamtzahl des Benchmarks, warum, und was jeweils dagegen getan wird.
Handykamera: 0,981
Ein Handyfoto trägt das Rauschen des Sensors, die Weichzeichnung des Objektivs und ungleichmäßiges Licht über die Seite. Die gezeichneten Buchstaben passen zur Unschärfe und zur Körnung, die um sie herum gemessen wurden, aber nicht genau genug: Die Messungen von Quantisierung und Beleuchtung trennen die Stelle noch immer von der Seite. Fast die Hälfte der auf Handyseiten angefragten Korrekturen wurde abgelehnt, die meisten, weil die Schräglage der Seite den Plan unsicher machte.
Als Nächstes: ein Modell des Sensorrauschens und eine Angleichung an den Kompressionsverlauf des Fotos, damit eine gezeichnete Stelle dieselbe Körnung und dasselbe JPEG trägt wie die Seite um sie herum.
Fax: 0,989
Eine Faxseite enthält nur Schwarz und Weiß. Die Buchstaben, die das Programm zeichnet, sind kantengeglättet, mit Grau an ihren Rändern, sodass sie auf einer Seite stehen, die sonst nirgends Grau hat, und eine Messung der Kantenformen oder des Rauschfelds findet sie sofort. Das zu wissen ist nicht dasselbe, wie es zu beheben.
Als Nächstes: auf einer Schwarz-Weiß-Seite in Schwarz und Weiß zeichnen, angepasst an die eigenen Strichstärken und Kantenstufen der Seite, statt in Grau.
Jedes Mal abgelehnt
Büroscanner, ein Wort hinzugefügt: 13-mal angefragt, 0-mal vorgenommen. Für diese Zeile gibt es keine Zahl, weil keine Korrektur vorgenommen wurde. Jeder Versuch wurde von den eigenen Prüfungen des Programms abgelehnt: Bei dieser Art von Scan ist das gezeichnete Wort messbar glatter oder schärfer als die JPEG-Struktur um es herum, oder es passt nicht in den dafür gemessenen leeren Platz. Das Programm lehnt ab, statt ein Wort zu setzen, das auffallen würde.
Und für das Auge eines Menschen
Detektoren sind das eine. Einer prüfenden Person wurden 20 Seitenpaare gezeigt, je ein Original und eine korrigierte Seite, in blinder Reihenfolge, mit der Frage, welche die korrigierte sei. Die Person lag 17-mal von 20 richtig; eine Münze läge in der Hälfte der Fälle richtig.
Die Blindprüfung, nach Scanbedingung
| Bedingung | Gefunden | Gezeigt |
|---|---|---|
| Handykamera | 5 | 5 |
| Büroscanner | 3 | 5 |
| Fax | 5 | 5 |
| Farbiger Briefkopf | 4 | 5 |
| Alle Bedingungen | 17 | 20 |
Die prüfende Person hatte die Testumgebung selbst gebaut und wusste, welche Wörter der Benchmark ändert; das ist also ein Ergebnis zur Fehlersuche, kein Maß dafür, was eine fremde Person sehen würde. Es wird veröffentlicht, weil es das ist, was gemessen wurde.
Eine Korrektur, Schritt für Schritt
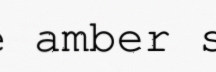
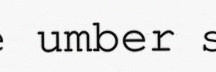
Statt des freundlichsten Beispiels zeigt diese Seite eines, das nach einer Regel gewählt wurde: ein ersetztes Wort, also die Korrektur, für die es das Werkzeug gibt, unter der Scanbedingung, deren Zeile für ersetzte Wörter der Gesamtzahl des Benchmarks am nächsten liegt; und innerhalb dieser Zeile die Seite, die die eigene Auswertung des Benchmarks untersucht, nämlich die angenommene Korrektur, die ein Detektor am leichtesten gefunden hat. Das ergibt Büroscanner, ein Wort ersetzt, Startwert (Seed) 73132: ein erfundener Brief, unter dieser Bedingung gescannt (ein Flachbettscan, als JPEG gespeichert, die häufigste Art von Scan überhaupt), in dem das Wort „amber“ in der ersten Zeile des Textes zu „umber“ wird.
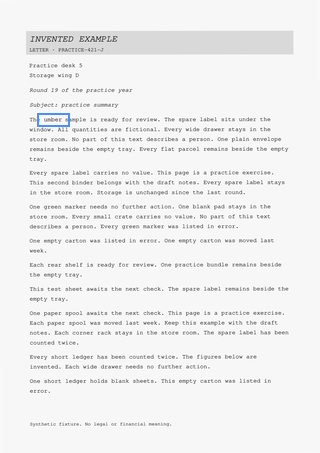
Wie sie gemacht wurde: An die umgebenden Buchstaben angepasst. Die Seite enthielt die Tinte nicht, die das neue Wort braucht, also wurden die Buchstaben passend zur Schrift daneben gezeichnet, mit Unschärfe, Körnung und Tintenfarbe aus der Umgebung der Auswahl.
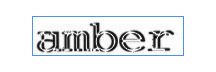
Die Ausschnitte unten sind die eigenen Pixel der Seite mit 300 Punkten pro Zoll, gezeigt in achtfacher Größe (vierfacher auf einem kleinen Bildschirm), jedes Pixel ein Quadrat und ohne Glättung; scrollen Sie seitwärts, um die ganze Zeile zu sehen. Jedes Pixel, das die Korrektur geändert hat, liegt im umrandeten Bereich des dritten Bildes.
Die Prüfung
4780 Pixel geändert, alle innerhalb des angegebenen Bereichs, der von (336, 904) bis (488, 944) im Raster von 300 Punkten pro Zoll reicht; 0 außerhalb davon geändert. Geprüft.
Was die Detektoren gefunden haben
Die Bewertung jedes Detektors auf dieser Seite
| Detektor | Was er misst | Bewertung |
|---|---|---|
| Rückstand der Neukompression | wie stark sich jeder Teil der Seite verändert, wenn er erneut als JPEG in mehreren Qualitätsstufen gespeichert wird | 0,944 |
| JPEG-Geisterbilder | die Spur, die eine zweite Kompression in der Rückstandskurve hinterlässt | 0,784 |
| Quantisierungsverlauf | ob die Kompressionskoeffizienten den eigenen Verlauf der Seite tragen oder einen anderen | 0,975 |
| Kompressionsraster | ob die Blockgrenzen des JPEG überall aufeinander ausgerichtet sind | 0,836 |
| Papierrauschen | ob die Körnung des leeren Papiers überall gleich ist | 0,734 |
| Spuren der Neuabtastung | der periodische Rückstand, den das Skalieren oder Drehen von Pixeln hinterlässt | 0,241 |
| Kantenschärfe | wie schnell Tinte entlang starker Kanten in Papier übergeht | 0,818 |
| Kopierte Blöcke | Pixelblöcke, die zweimal auf der Seite vorkommen | 0,498 |
| Beleuchtung | ob die Helligkeit des Papiers einem einzigen gleichmäßigen Lichtfeld folgt | 0,721 |
| Schwarz-Weiß-Formen | die Größen, Formen und Lauflängen der Tinte auf einer Seite ohne Grau | nicht anwendbar |
Am stärksten war der Quantisierungsverlauf, mit 0,975, und das ist die AUFFINDBARKEIT dieser Seite. Klar gesagt: Unser eigener Detektor hat diese Korrektur genau umrandet. Die Ähnlichkeit im geänderten Rahmen lag bei 0,287, und die Schärfe der Stelle gegenüber ihrem Ring bei 1,935, die gezeichneten Buchstaben lesen sich also etwas sauberer als der Scan um sie herum. Die Ausschnitte stehen oben, damit Sie selbst urteilen können.
Das Protokoll und ein Zertifikat
Die korrigierte Datei trägt ihr eigenes Protokoll, einen Anhang namens
provenance.json. Für diese Korrektur hält es fest: Seite
1, der Bereich von (336, 904) bis (488, 944) bei
300 Punkten pro Zoll, „amber“ vorher und
„umber“ nachher, mit dem Ergebnis „An die umgebenden Buchstaben angepasst“, geprüft, mit 4780 geänderten Pixeln
und 0 außerhalb des angegebenen
Bereichs, von Programmversion 0.1.1. Das Protokoll weist die Datei als
korrigierte Kopie aus. Es ist eine Angabe, die die Datei über sich selbst macht; der Nachweis
ist das eigene Protokoll des Dienstes, wie So funktioniert es erklärt.
Ein Prüfzertifikat ist eine signierte Erklärung derselben Messungen, ausgestellt im Business-Tarif für ein korrigiertes Dokument, die jede Person bei der Zertifikatsprüfung ohne Konto prüfen kann. Was eine Prüfung belegt, Feld für Feld, steht in The verification model (auf Englisch).
Für diese Korrektur wurde kein Zertifikat ausgestellt: Zertifikate werden für Korrekturen im laufenden Dienst ausgestellt, und diese wurde im Benchmark gemacht. Ein Zertifikat würde die Messung oben enthalten, signiert.
Die Buchstaben wurden mit den Schriften gezeichnet, mit denen der Dienst läuft, und mit keinen anderen, damit dieses Beispiel das ist, das der Dienst erstellen würde; CECO PDF hält diese Seite daran, indem es das Beispiel neu erzeugt, auf dem eigenen Schriftensatz des Dienstes, sobald sich das Programm ändert.
Wie Sie diese Zahlen prüfen können
Alles auf dieser Seite wird aus den festgeschriebenen Ergebnissen des Benchmarks erzeugt, und dieselben Daten werden als JSON ausgeliefert, sodass ein Programm die Zahlen lesen und mit der Seite vergleichen kann. Der Benchmark, die Detektoren und der Generator für den Korpus gehören zum eigenen Code des Programms und zu seinen Tests. Der Korpus ist erfunden und aus einem Startwert erzeugt: Kein echtes Dokument und kein Dokument einer Kundin oder eines Kunden ist darin oder wird es je sein.
Die Seite wird nicht von Hand aktualisiert. Wenn der Benchmark erneut läuft und seine Ergebnistabelle veröffentlicht wird, wird diese Seite daraus neu erzeugt, und ein Test schlägt fehl, wenn die beiden nicht übereinstimmen.
Sie dürfen diese Zahlen, von dieser Seite oder aus dem JSON, unter der Lizenz Creative Commons Attribution 4.0 International weiterverwenden: Nennen Sie CECO PDF als Quelle und verlinken Sie diese Seite. Die Lizenz gilt für die Messungen, nicht für das Programm, den Dienst oder den Rest dieser Website.
Was diese Zahlen nicht sagen
Die Zahlen sind an erfundenen Seiten gemessen, nicht an Kundendokumenten, die den Dienst nie verlassen und nie als Testdaten verwendet werden. Vier Scanbedingungen und vier Arten von Korrekturen sind ein Regressionstest, nicht die Welt, und eine Zahl hier ist eine Eigenschaft dieses Tests an dem Tag, an dem sie gemessen wurde.
Es sind die Zahlen unserer eigenen Detektoren. Eine Dokumentenprüferin oder ein Dokumentenprüfer mit anderen Werkzeugen, mehr Zeit oder einem Ausdruck der Seite kann finden, was diese nicht finden, und eine niedrige Zahl hier wäre kein Versprechen, dass sich eine Korrektur nicht finden lässt. Heute sind die Zahlen nicht niedrig.
Eine Korrektur wird nie gemacht, um verborgen zu werden. Jede trägt die Bestätigung der Person, die sie verlangt hat, und ein Protokoll in der Datei, und die Nutzungsbedingungen sagen, wer ein Dokument ändern darf: nur, wer berechtigt ist, es zu ändern. Diese Messungen werden veröffentlicht, damit sich die Aussage, dass sich sonst nichts auf der Seite geändert hat, prüfen lässt, und damit bekannt ist, was das Werkzeug tut, statt dass man es erraten muss.
Zuletzt aktualisiert